Lambda 에 올린 자바 코드는 깊게 생각하지 않는다면 서버와 같은 어셈블리로 실행된다고 간주할 수 있다. JDK 버전이 같고 jar 도 같으니 당연해 보인다. 나도 그렇게 생각했다.
사실 아무 생각 없이 올렸던 코드가 크래시 로그 하나만 남기고 죽었다. AWS Lambda 에서 돌던 크롤러 함수가 170여 번 실행되는 동안 한 번 크래시했다. 자바 예외가 아니라 JVM 프로세스 자체가 죽은 것이다. 크래시 로그가 가리킨 곳은 jsoup 1.18.3 의 TokenQueue.matchesAny1 였다.
public boolean matchesAny(char... seq) {
    if (isEmpty()) return false;
    for (char c : seq) {
        if (queue.charAt(pos) == c)
            return true;
    }
    return false;
}
위 코드는 문자열에서 글자 하나를 꺼내 후보 문자들과 비교하는 로직이다. 잘못될 구석이 없어 보이고, 실제로 같은 코드가 쿠버네티스 클러스터에서는 한 번도 크래시하지 않았다. 같은 JDK 버전, 같은 jar, 같은 코드인데 무엇이 달랐을까?
답부터 말하면, 차이는 Lambda 의 Java 21 런타임이 JIT 컴파일러를 C1 하나로 묶어 둔다는 데 있었다. 그 모드에서만 켜지는 최적화가 문자열에서 글자를 읽는 로드를 범위 검사보다 앞으로 끌어올렸고, 이는 OpenJDK 에 이미 보고된 결함 JDK-8386708 이었다.2 JDK 21 에는 아직 수정이 들어오지 않아, 그 최적화 하나를 JVM 플래그로 꺼서 우회했다. 효과는 플래그만 다른 Lambda 함수 두 개로 돌린 A/B 와, 프로덕션 크래시를 크래시 지점까지 똑같이 만든 로컬 재현으로 확인했다.
이번 글은 AI 코딩 에이전트와 함께 이 크래시를 쫓은 기록이다. JVM 컴파일러 레벨에 대한 이해와 그로 인한 시행착오, 그리고 결국 어떻게 되었는지를 다룬다. 크래시 로그 해석과 소스 추적, 실험 코드는 대부분 에이전트가 맡았고, 나는 판단과 검증, 그리고 조치에 대한 결정을 했다. 그 판단이 늘 옳지는 않았다. 답을 손에 쥐고도, 엉뚱한 가설로 실험을 6만 번 돌린 적도 있다.
1부. 크래시 로그가 가리킨 여섯 줄
Lambda 로그에 크래시 리포트가 찍혔다
릴리즈스톡의 검색 크롤러는 평소 쿠버네티스 클러스터 안에서 도는데, 그중 일부를 AWS Lambda 로 옮겨, x86 과 arm64 두 함수로 시험하던 참이었다. 그런데 인클러스터(쿠버네티스 클러스터 안)에서는 문제없던 코드가 x86 함수에서 실패했다. 일주일 동안 170여 번 실행되는 사이 단 한 번이었다.
피해는 작았다. 클러스터 쪽 크롤러가 곧 같은 매장을 이어받아 수집 공백은 30여 분으로 끝났고, 유실된 데이터도 없었다. 문제는 원인이었다. 내 코드도 입력도 아닌 곳에서 JVM 이 죽었고, 원인을 모르면 이 함수를 Lambda 에 계속 둘지 정할 수 없었다.
JVM 의 크래시 로그(hs_err)는 보통 파일로 떨어진다. 그런데 Lambda 런타임은 JVM 에 이 로그를 표준 에러로 쓰라는 플래그(-XX:+ErrorFileToStderr)를 넘기고, 표준 에러는 CloudWatch 로그로 간다. 그래서 응답 대신 hs_err 가 그대로 찍혔다.
#  SIGSEGV (0xb) at pc=0x00007f9184ee747f, pid=2, tid=27
#  JRE: Corretto-21.0.12.8.1 (21.0.12+8-LTS)
#  Java VM: ... mixed mode, emulated-client, sharing, tiered, compressed oops, serial gc, linux-amd64
# Problematic frame:
# J 2698 c1 org.jsoup.parser.TokenQueue.matchesAny([C)Z (55 bytes) @ 0x00007f9184ee747f [0x00007f9184ee73c0+0x00000000000000bf]
siginfo: si_signo: 11 (SIGSEGV), si_code: 2 (SEGV_ACCERR), si_addr: 0x00000000a1210004
hs_err 에서 추린 이 여섯 줄에서 단서 세 개를 읽을 수 있다.
첫째, SIGSEGV 는 프로세스가 접근 권한이 없는 메모리를 건드려 운영체제에게 강제 종료당했다는 뜻이다. 자바 예외가 아니라서 try-catch 로 잡을 수 없다. 자바 코드의 실수였다면 예외로 끝났을 일이다.
둘째, J 2698 c1 은 크래시 지점을 적은 문제 프레임(Problematic frame) 정보다. 2698 은 JIT 컴파일 번호, c1 은 그 코드를 만든 컴파일러이고, 대괄호 끝의 +0xbf 는 컴파일된 코드 안에서 크래시한 명령의 위치(오프셋)다. 즉 크래시는 C1 컴파일러가 생성한 어셈블리 안에서 일어났다. Oracle 의 트러블슈팅 문서3는 이런 경우를 컴파일러가 잘못된 코드를 생성했을 가능성으로 분류한다.
셋째, emulated-client 는 JVM 이 자기 컴파일 모드를 VM 이름에 적어 둔 문자열이다. HotSpot 은 JVM 이 C1 레벨 1 로만 돌도록 묶였을 때 이 문자열을 붙이고4, 그렇게 묶는 대표적인 방법이 -XX:TieredStopAtLevel=1 이다. 그런데 나는 그런 플래그를 설정한 적이 없었다.
입력 데이터도 메모리도 아니었다
크롤러가 죽었으니 처음에는 매장 HTML 이 이상한 게 아닐까 의심했다. 하지만 hs_err 에 남은 자바 스택을 보면, 호출자는 HTML 파서가 아니라 CSS 셀렉터 파서(QueryParser)였다. 크롤러는 이미 파싱을 마친 매장 HTML 에서 매물 요소마다 selectFirst 를 부르고 있었고, jsoup 은 그 셀렉터 문자열을 해석하던 중이었다. 레지스터가 가리키던 객체를 풀어 보면 해석하던 문자열이 보인다(지면상 요약했다).
RSI = org.jsoup.parser.TokenQueue
- pos   = 6
- queue = ".name a"
queue 필드의 ".name a" 는 내 코드에 하드코딩된 셀렉터다. 죽은 자리의 문자열에 매장이 보낸 글자는 하나도 없었으니, 입력 데이터 가설은 여기서 끝났어야 했다.
다음으로 메모리를 의심했지만, 크래시 순간 힙 사용량은 상한 1.5GB 에 한참 못 미쳤다. 자바 힙이 모자랐다면 JVM 은 SIGSEGV 가 아니라 OutOfMemoryError 를 던졌을 것이다.
크래시는 C1 컴파일러가 만든 어셈블리 안에서 났고, JVM 은 내가 설정한 적 없는 C1 전용 모드로 돌고 있었다. 입력 데이터와 메모리 부족은 후보에서 빠졌다. 남은 질문은 하나였다. 같은 코드가 인클러스터에서는 왜 한 번도 죽지 않았을까?
2부. 범위 검사보다 먼저 실행된 로드
Lambda 의 JVM 은 C1 하나로 돈다
인클러스터 파드에서 JVM 플래그를 뽑아, Lambda 의 hs_err 에 찍힌 값과 나란히 놓았다.
| 항목 | 인클러스터 | Lambda |
|---|---|---|
| JDK | Temurin 21.0.12+8 | Corretto 21.0.12+8 |
| VM 모드 | mixed mode, sharing |
mixed mode, emulated-client, sharing |
TieredStopAtLevel |
4 | 1 |
UseLoopInvariantCodeMotion |
true | true |
벤더는 달라도 버전은 같았고, 결정적인 차이는 TieredStopAtLevel 한 줄이었다.
JVM 은 바이트코드를 인터프리터로 실행하다가, 자주 불리는 메서드만 JIT 컴파일러로 번역한다. HotSpot 의 번역기는 둘이다. C1 은 빠르게 번역하지만 코드 품질은 보통이고, C2 는 실행 중 모은 프로파일로 훨씬 나은 어셈블리를 만들지만 번역이 느리다. 계층형 컴파일(tiered compilation)은 둘을 0~4 다섯 레벨로 묶어 쓴다.5 보통의 메서드는 C1 이 프로파일을 모으는 레벨 3 을 거쳐 C2 의 레벨 4 로 간다. 레벨 1 은 프로파일 없이 C1 에서 멈추는 막다른 길이고, -XX:TieredStopAtLevel=1 로 여기에 묶으면 C2 는 아예 기동하지 않는다.
그런데 AWS Lambda 문서6를 보면, Lambda 의 Java 17 과 Java 21 런타임은 이 값을 기본으로 적용한다.
"For Java 17 and Java 21, Lambda configures the JVM to stop tiered compilation at level 1 by default."
콜드 스타트가 중요한 짧은 함수에서 C2 는 결과도 못 내고 CPU 만 차지하기 때문이다. 그런데 차이는 C2 로 넘어가느냐에서 끝나지 않는다. 같은 메서드라도, 레벨 1 로 묶인 C1 은 계층형 컴파일 속의 C1 과 다르게 컴파일한다. 그 차이가 크래시가 되기까지는 두 단계를 거친다.
① Lambda 의 C1 은
matchesAny가 불릴 때마다, 범위 검사보다 먼저 메모리를 읽는다.
② 그 잘못된 읽기는 대부분 조용히 버려지고, 운 나쁘게 힙 끝에 걸릴 때만 JVM 을 죽인다.
첫 단계는 컴파일러가 만든 결함이고, 둘째 단계는 GC 가 만든 우연이다.
① 매번 검사보다 먼저 읽는다
C1 은 단순한 컴파일러지만 보통은 틀린 코드를 만들지 않는다. 문제는 C1 이 레벨 1 로 묶였을 때만 켜는 최적화 하나였다. 루프 불변 코드 이동(Loop Invariant Code Motion, 이하 LICM)이다. 루프 안에서 값이 변하지 않는 계산을 루프 밖으로 빼서 한 번만 실행하는 고전적인 최적화다.
C1 은 이 최적화를 아무 때나 하지 않는다.7 C1 만 쓰면서 프로파일도 모으지 않을 때, 즉 레벨 1 로 묶였을 때만 한다.8 계층형 컴파일에서는 뒤에 C2 가 있으니 C1 이 무리할 필요가 없다는 설계다. 그래서 앞의 표에서 UseLoopInvariantCodeMotion 은 양쪽 다 true 였는데도, 인클러스터의 C1 은 LICM 을 한 번도 하지 않았고 Lambda 의 C1 은 매번 했다.
matchesAny 의 루프는 LICM 이 좋아할 모양이다.
for (char c : seq) {
    if (queue.charAt(pos) == c)   // pos 가 변하지 않는다
        return true;
}
보통의 파서는 루프를 돌며 pos 를 증가시킨다. 그런데 matchesAny 는 같은 위치의 글자 하나를 여러 후보 문자와 비교하므로 pos 가 변하지 않고, queue.charAt(pos) 가 통째로 끌어올릴 대상이 된다.
문제는 charAt 안에 경로가 둘 있다는 점이다. 자바 9 부터 문자열은 라틴 문자만 담으면 글자당 1바이트(Latin-1)로, 그 외 문자가 섞이면 글자당 2바이트(UTF-16)로 저장한다. charAt 은 문자열의 coder 필드를 보고 두 경로로 갈린다.9
public char charAt(int index) {
    if (isLatin1()) return StringLatin1.charAt(value, index);  // 범위 검사를 달고 다니는 배열 접근
    else            return StringUTF16.charAt(value, index);   // checkIndex 로 검사한 뒤 getChar 로 읽는다
}
C1 은 컴파일 시점에 coder 값을 모르니 두 경로를 모두 컴파일하고, LICM 은 두 경로의 로드를 모두 루프 밖으로 끌어올렸다. 두 로드의 운명은 여기서 갈렸다.
Latin-1 쪽 로드는 범위 검사를 달고 다니므로, 로드가 움직이면 검사도 따라 움직인다. UTF-16 쪽 getChar 는 인트린직(intrinsic)이다. 인트린직이란 짧게 설명하자면 JIT 컴파일러가 메서드 호출을 자기가 아는 연산으로 바꿔 끼운 것이다. C1 은 이 인트린직에서 범위 검사를 뺐다.10 바로 앞의 checkIndex 가 이미 검사하니 중복이라는 이유였다.
'checkIndex 가 이미 검사했다'는 이 전제는, 로드가 검사 뒤에 머물러 있을 때만 성립한다. LICM 이 로드만 루프 밖으로 끌어올리자, UTF-16 로드는 검사를 두고 혼자 앞으로 나갔다. hs_err 가 덤프한 기계어를 역어셈블하면 그 흔적이 그대로 보인다.
;; ---- 루프 밖 ----
0x...744f  cmp    edi, r8d                   ; Latin-1 로드의 범위 검사      <= 검사가 있다
0x...745b  movsx  r9d, byte [rax+r9+16]      ; Latin-1: value[6] = 'a'
0x...747f  movzx  r13d, word [rax+2*r13+16]  ; UTF-16 로드                   <= PC. 검사가 없다

;; ---- 루프 안 ----
0x...74b1  test   ebx, ebx                   ; coder 분기는 루프 안에 남았다
0x...7505  cmp    r8d, eax                   ; checkIndex 가 로드보다 뒤에 있다
UTF-16 로드가 루프 밖에, 그것도 checkIndex 보다 앞에 있다. ".name a" 는 Latin-1 문자열이라 자바 의미론상 UTF-16 경로를 실행할 일이 없다. 그런데 어셈블리는 coder 분기보다 먼저, UTF-16 보폭(글자당 2바이트, 어셈블리의 2*r13)으로 주소를 계산해 읽었다. 프로그램 논리상 실행될 수 없는 로드가 실행된 것이다. 이 로드가 읽으려던 주소는 hs_err 가 크래시 주소로 적은 si_addr(0xa1210004)과 정확히 일치한다.
한 가지 조건이 더 있다. 이 UTF-16 경로가 컴파일되려면 StringUTF16 클래스가 로딩돼 있어야 하고, 그러려면 JVM 안에 UTF-16 문자열이 하나라도 있어야 한다. 내 크롤러에서는 한글 매물 제목이 이 클래스를 로딩시켰다. 그러니 이 결함은 한글 문제도 문자셋 문제도 아니다. 라틴 문자 밖의 글자라면 무엇이든, 음표 기호(♫) 한 글자여도 같은 역할을 한다.
② 가끔 힙 끝에 걸린다
여기까지 오자 오히려 이상해졌다. 잘못된 로드가 호출마다 실행됐다면 크롤러는 매번 죽었어야 한다. 그런데 실제로는 170여 번에 한 번이었다.
도서관 서가에 빗대 보자. 커밋된 힙은 불이 켜진 서가이고, 그 너머는 자물쇠가 걸린 창고다. 문제의 로드는 책을 짚는 손이다. 배열이라는 책의 뒤쪽 페이지를 찾을 때면, 이 손이 책 끝보다 조금 더 나간다. UTF-16 보폭으로 두 배씩 건너뛰니, 문자열의 뒤쪽 절반을 읽을 때는 배열 끝을 넘어서는 것이다. 보통은 옆 책에 손이 닿을 뿐이고, 넘어 읽은 값은 coder 분기가 Latin-1 쪽을 고르면서 조용히 버려진다. 그런데 사서인 GC 가 책을 정리하다 하필 이 책을 불 켜진 구역의 맨 마지막 칸에 꽂아 두면, 뻗은 손은 창고 자물쇠를 건드리고 경보가 울린다. 그 경보가 SIGSEGV 다.
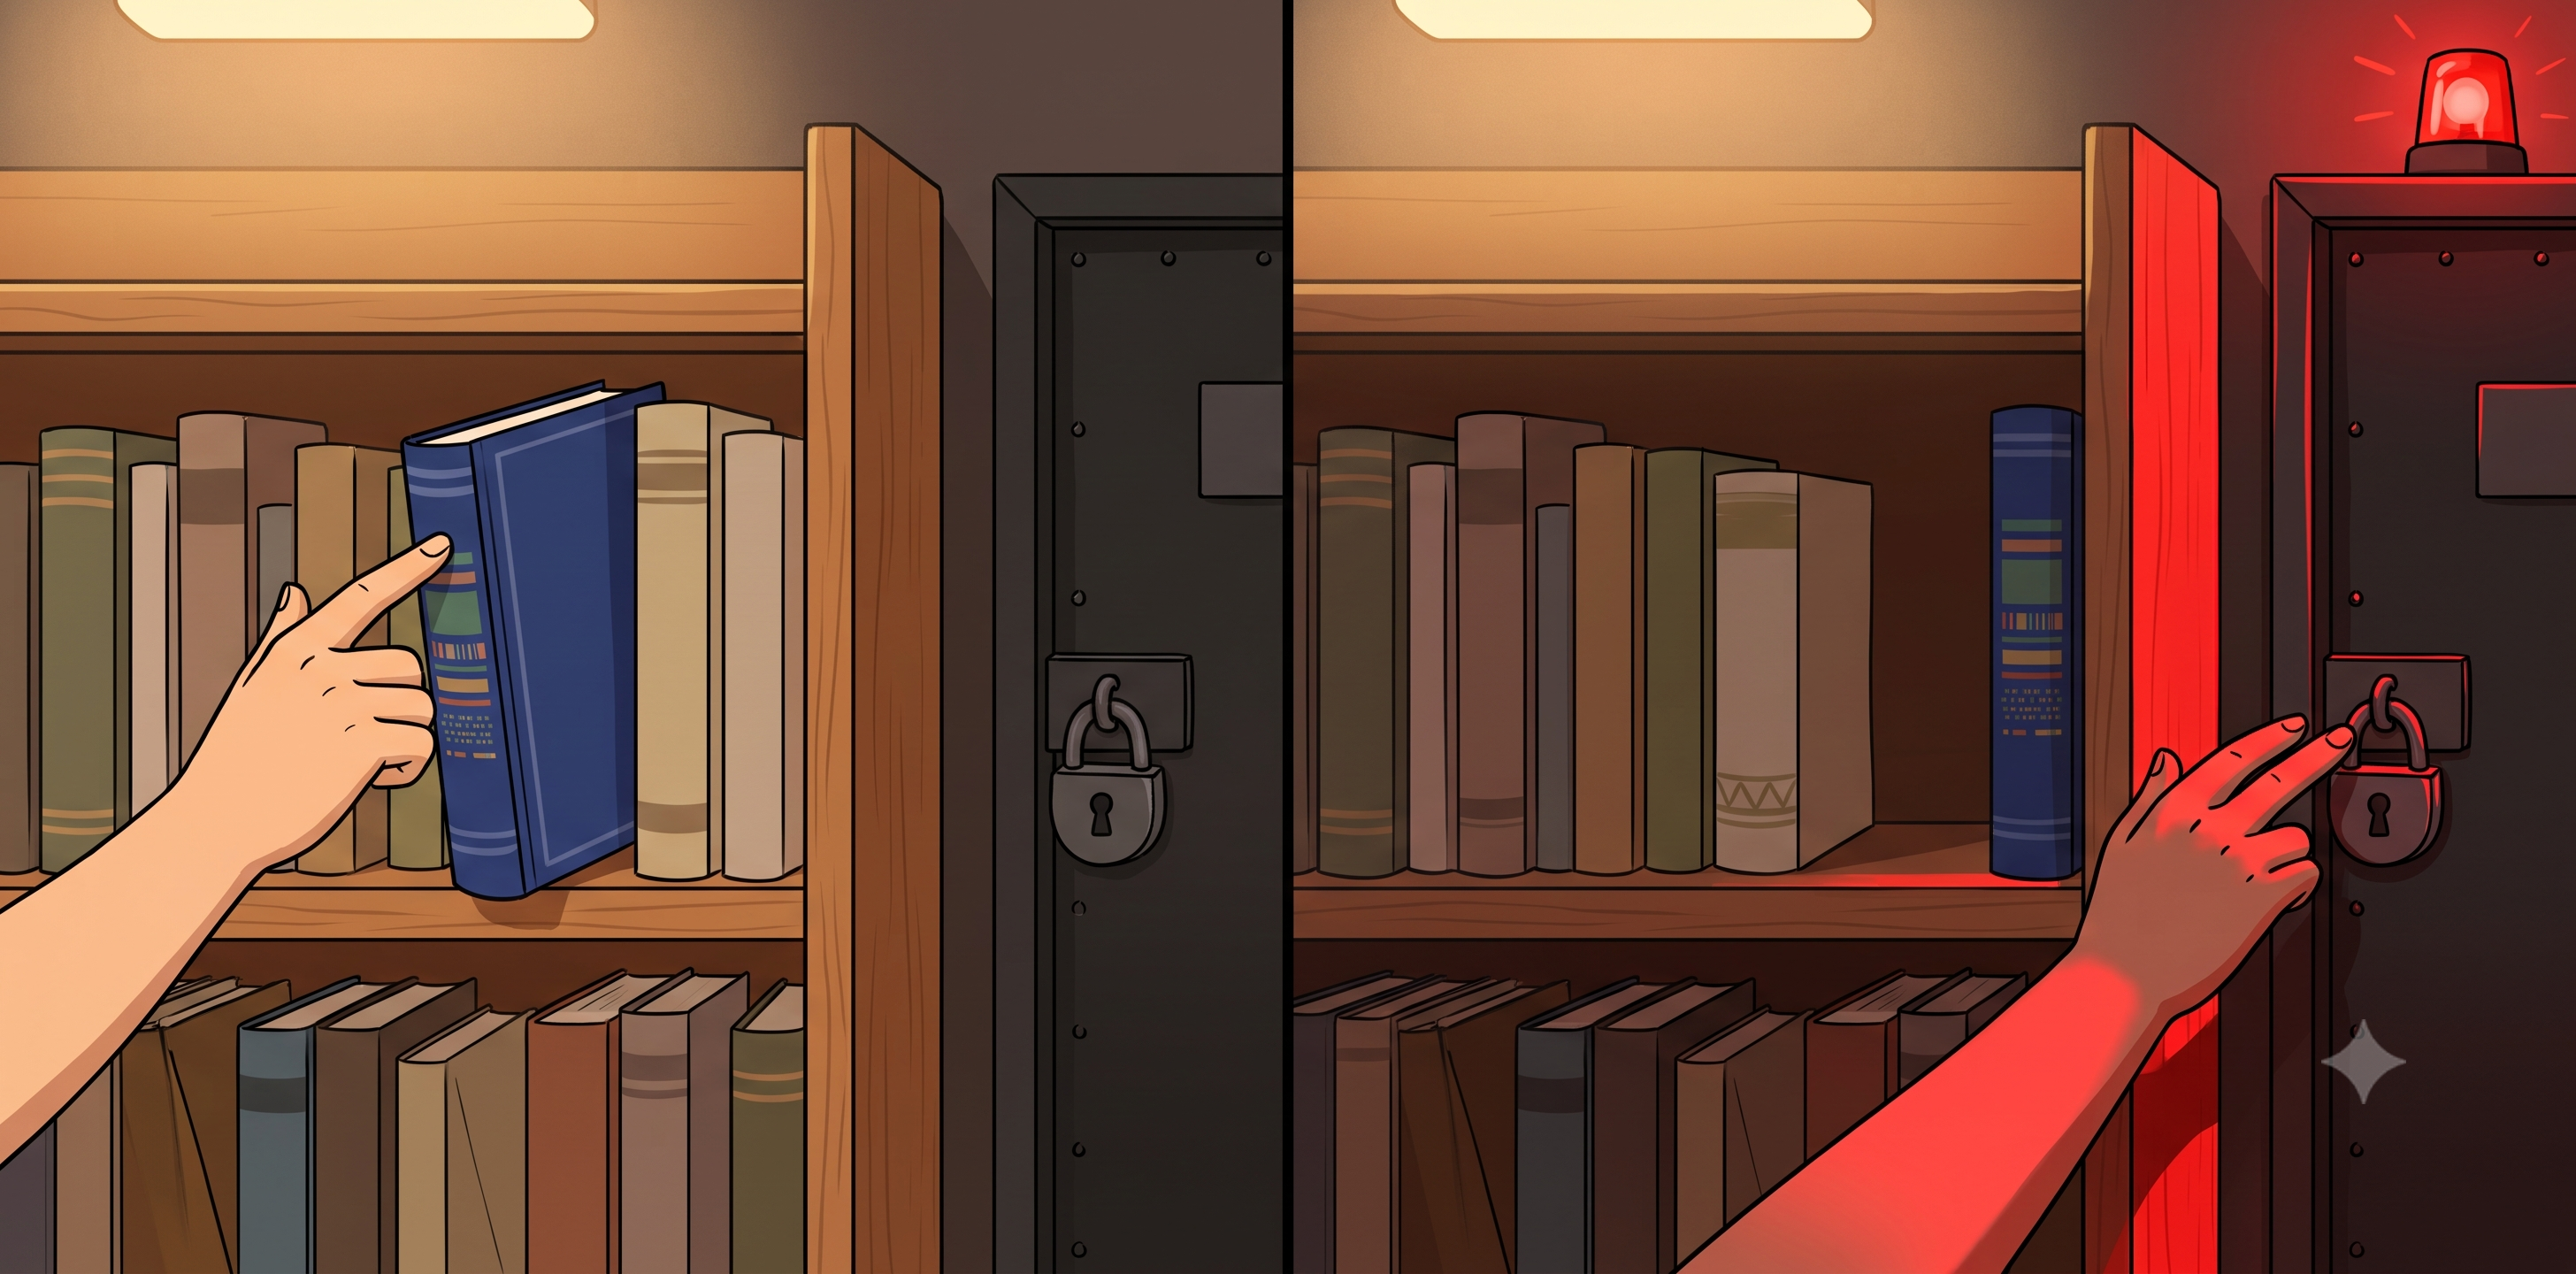
왼쪽은 평소, 오른쪽은 GC 가 책을 맨 끝 칸에 꽂아 둔 순간이다.
hs_err 끝자락의 메모리 지도가 바로 그 순간을 보여 준다.
a0600000-a1210000 rw-p     <= 여기까지가 커밋된 영역 (불 켜진 서가)
a1210000-c0400000 ---p     <= 여기부터는 읽기만 해도 죽는다 (잠긴 창고)
크래시한 주소는 0xa1210004, 커밋된 영역이 끝나는 0xa1210000 에서 딱 4바이트 너머였다. 크래시 12밀리초 전에 GC 가 문제의 배열을 survivor 공간의 맨 끝으로 복사해 둔 것이다. 36MB 남짓한 Lambda 의 힙에서는 GC 가 4초에 14번 돌 만큼 잦아서, 배열이 자리를 옮길 기회 자체는 많다.
레벨 1 의 C1 은 LICM 으로 getChar 의 로드를 범위 검사 앞으로 끌어올렸고, matchesAny 는 호출될 때마다 엉뚱한 메모리를 읽었다. 결함은 매번 발동했고, 드물었던 것은 GC 가 배열을 힙 끝에 붙여 둔 순간뿐이었다. 원인은 이것으로 설명이 끝난다. 하지만 남은 일은 설명이 아니었다. 결함을 어떻게 막을지, 그리고 막았다는 것을 어떻게 증명할지였다.
3부. 세 번의 조치와 한 번의 헛걸음
1·2부의 해석은 원인을 다 알고 난 뒤에 정리한 것이다. 실제로 나는 원인을 모르는 채 조치부터 해야 했다.
1차: 가장 안전하다고 믿은 모드
크래시 로그를 처음 받았을 때 내가 아는 것은, 크래시가 C1 이 만든 코드 안에서 났고 이 JVM 이 C1 만 쓴다는 것까지였다. 그 C1 이 이미 레벨 1 로 묶여 있다는 것은 몰랐다. 에이전트가 내놓은 가설 몇 가지 가운데 내가 고른 것은 C1 을 가장 단순하게 돌리는 쪽이었다. 나는 JAVA_TOOL_OPTIONS 환경 변수에 -XX:TieredStopAtLevel=1 을 넣었다. 레벨 1 은 프로파일도 모으지 않는 가장 단순한 C1 이니, 결함이 공격적인 최적화 쪽에 있다면 비켜 갈 거라고 봤다.
정반대였다. 2부에서 봤듯 C1 가운데 LICM 까지 켜고 가장 공격적으로 최적화하는 모드가 바로 레벨 1 이다. 게다가 hs_err 의 emulated-client 가 보여 주듯 Lambda 는 이미 레벨 1 로 돌고 있었다. 나는 이미 눌린 스위치를 한 번 더 누른 셈이다.
2차와 3차: 한 메서드에서 메커니즘으로
두 번째로는 문제의 메서드 하나만 컴파일에서 빼는 CompileCommand=exclude 를 골랐다. 결함의 정체를 모르는 채, 크래시가 난 자리만이라도 막자는 선택이었다. 하지만 같은 위치의 글자를 루프 안에서 읽는 메서드는 어디에나 있을 수 있었고, 이 변경은 AWS 에 적용되기도 전에 바뀌었다.
에이전트가 OpenJDK 버그 트래커(JBS)에서 JDK-8386708 을 찾아왔고, 결함의 정체와 메커니즘이 함께 보였다. 나는 한꺼번에 다 증명하려 하지 말고, 불확실성을 한 꺼풀씩 걷어내 가기로 했다. 여러 가지를 한 번에 검증하면 에이전트가 돌려 오는 결과가 뒤섞이고, 나도 보고 싶은 쪽으로 읽기 쉽다고 봤다. 세 번째 조치는 LICM 을 끄는 플래그 하나였고, x86 과 arm64 함수 양쪽에 적용했다.
JAVA_TOOL_OPTIONS = "-XX:-UseLoopInvariantCodeMotion"
근거는 JDK 28 에 들어간 상류 수정 커밋 9b357dac11 의 주석이다.
The getChar() method in Java is preceded by a checkIndex() that performs the effective range check. However, this means that the load must not float over the check. That we cannot guarantee with a LoadIndexed, in particular LICM will hoist such accesses. For this reason we use an UnsafeGet access to pin the load.
주석은 굵게 표시한 부분에서, LICM 이 바로 이런 로드를 범위 검사 앞으로 끌어올린다고 콕 집어 말한다.
2차 조치까지 겹쳐 넣어 두 겹으로 막고 싶은 유혹도 있었다. 하지만 메서드 제외를 남겨 두면, LICM 을 끈 조치가 결함을 못 막더라도 그 메서드에서는 크래시가 드러나지 않는다. 나는 더 안전해 보이는 쪽 대신 증명할 수 있는 쪽을 골랐다.
걷어낼 첫 꺼풀은 플래그가 정말 적용됐는가였다. -XX:+PrintFlagsFinal 을 켜면 JVM 이 플래그마다 최종값과 그 값의 출처를 찍어 준다.
bool UseLoopInvariantCodeMotion = false {C1 product} {environment}    <= 내가 환경 변수로 넣은 값
intx TieredStopAtLevel          = 1     {product}    {command line}   <= 런타임이 명령줄로 넣은 값
내 플래그에는 {environment} 가 붙어 제대로 적용됐다. 레벨 1 은 {command line}, 런타임이 넣은 값이었다.
기다리지 않기로 했다
막는 방법은 정해졌고, 이제 막았다는 것을 증명해야 했다. 조치 뒤 크래시는 다시 나지 않았다. 하지만 기저율이 170여 번에 한 번이라면, 아무 조치를 안 했더라도 일주일 동안 한 번도 안 죽을 확률이 37% 다. 우연과 구분하려면 3주 가까이 지켜봐야 했고, 그 기저율조차 크래시 한 건에서 나온 추정이었다.
그래서 나는 기다리지 않기로 했다. 그리고 실제 Lambda 로 가기 전에 로컬에서 먼저 확인하기로 했다. 과금은 거의 없었겠지만, 운영 환경에서 실험하는 비용은 따져야 했다. 로컬 JDK 에서는 상류 커밋의 회귀 테스트로, LICM 을 끄면 크래시가 사라지는 것을 확인했다. 다만 그 JDK 는 Lambda 의 JVM 이 아니었고, 상류 테스트는 프로덕션 크래시와 모양도 달랐다.
헛걸음
여기서 나는 길을 잃었다.
이 조사는 AI 코딩 에이전트와 함께, 여러 작업 세션으로 나눠 진행했다. 크래시 당일 한 세션이 hs_err 를 역어셈블해 크래시 문자열 ".name a" 와 pos=6 까지 정리해 두었다. 그런데 다른 일정과 작업 때문에 열흘 뒤 이 사건을 다시 연 세션은 그 기록을 넘겨받지 못한 채 출발했고, 원본 hs_err 는 로그 보존 기간이 지나 이미 사라진 뒤였다.
같은 무렵, 크래시와는 상관없어 보이는 문제가 하나 따로 있었다. 한 매장이 홈페이지 문자셋을 EUC-KR 에서 UTF-8 로 바꿨는데, 크롤러는 그 매장 페이지를 여전히 EUC-KR 로 읽고 있었다. 그 사이 수집된 매물 제목은 글자가 깨져 들어왔고, 크래시가 난 바로 그날 별도 이슈로 디코딩을 고쳤다.
열흘 뒤 나는 이 두 사건을 한 자리에 놓고 봤다. 이 함수의 오류 그래프에는 생애 통틀어 스파이크가 딱 하나 있었는데, 그 스파이크가 하필 제목이 깨져 들어오던 짧은 구간 안에 떨어져 있었다. 그 매장이 문자셋을 바꾸기 전 닷새 동안, 이 함수는 같은 코드와 같은 JVM 플래그로 130번 남짓 돌았고 한 번도 죽지 않았다. 바뀐 것은 입력, 그중에서도 깨진 글자뿐으로 보였다.
그때 내가 놓친 것은 두 가지였다. 하나는 크래시 당일의 분석이다. 그 분석은 크래시 문자열 ".name a" 가 Latin-1 이고 인덱스도 범위 안이라고 이미 말하고 있었다. 내 손에는 그 대신, 며칠 전 상류 회귀 테스트를 보고 적어 둔 "UTF-16 문자열에서 범위 밖 인덱스를 읽어야 난다"는 한 줄이 있었다. 합성 테스트의 모양을 프로덕션에 그대로 옮긴 일반화였고, 그 한 줄에 비추면 깨진 글자가 섞인 이상한 문자열이 그 조건을 만들 수도 있어 보였다. 다른 하나는 맞지 않는 조각이다. 크래시는 셀렉터를 해석하다 났는데, 깨진 글자는 매장 페이지에 있었다. 나는 이것을 가설을 버릴 이유가 아니라 아직 모르는 것으로 남겨 두었다. 시점만 겹친 두 사건을, 틀린 모델과 미뤄 둔 의문이 하나로 묶은 것이다.
그래서 깨진 글자가 방아쇠였는지 가려 보기로 했다. 운영 함수와 분리한 실험용 함수 두 개를 세우고, 같은 jar 에 LICM 을 끄는 플래그 유무만 달리했다. LICM 을 켠 함수에서만 깨진 문자열이 크래시를 낸다면, 그 크래시가 JDK-8386708 이었다고 확정할 수 있다.
본 실험 전에는 게이트를 달았다. 상류 회귀 테스트를 먼저 돌려, 실험이 크래시를 제대로 잡아내는지, 즉 검출기가 살아 있는지 확인하는 단계다. 실험은 함수마다 20번씩 호출했고, LICM 을 그대로 둔 함수에서 세 번, 끈 함수에서 두 번 따로 돌렸다. 결과는 매번 같았다.
JAVA_TOOL_OPTIONS |
호출(1회 실험당) | 정상 완료 | 크래시 |
|---|---|---|---|
| 없음 (Lambda 기본) | 20 | 0 | 20 |
-XX:-UseLoopInvariantCodeMotion |
20 | 20 | 0 |
이 게이트는 그 자체로 실제 Lambda 에서 조치가 통한다는 첫 증거가 됐다. 하지만 정작 쫓던 가설 쪽은 사정이 달랐다.
본 실험에서는 매장 페이지 스냅샷과 일부러 깨뜨린 문자열로 6만 번 넘게 크롤링했고, 크래시는 한 번도 없었다. 게이트가 20번 중 20번 크래시를 잡았으니 검출기도 살아 있다고 봤다. 그래서 나는 6만 번의 0건을 가설을 버릴 근거로 읽었다.
틀린 추론이었다. 게이트의 상류 테스트는 "♫".charAt(1000_000_000) 처럼 UTF-16 문자열에서 배열 2GB 너머를 읽게 해서, 배열이 어디 놓이든 매번 죽는다. 서가로 치면 건물 밖으로 손을 뻗는 셈이다. 반면 프로덕션 크래시는 배열 끝을 몇 바이트 넘친 것이라, GC 가 배열을 힙 끝에 붙여 둔 순간에만 죽는다. 이 검출기가 그런 크래시를 잡을 수 있는지는 확인한 적이 없었다. 게다가 실험에서는 매장 서버 대신 스텁이 응답했고, 한 실험 안에서 스텁은 매번 같은 바이트를 돌려줬다. 그래서 크래시를 좌우하는 힙 배치는 오히려 프로덕션보다 단조로웠다. 6만 번의 0건은 가설이 틀려서인지, 경보가 울릴 자리를 한 번도 밟지 않아서인지 구분할 수 없었다.
6만 번이 다 돈 뒤에야, 미뤄 두었던 의문이 다시 내 눈에 걸렸다. 원인은 글자라는데 크래시는 셀렉터에서 났다. 그 의문을 따라 크래시 당일의 분석으로 돌아가고서야, "무엇이 범위 밖 인덱스를 만들었나" 라는 질문 자체가 틀렸다는 것을 알았다. 나는 실험을 접고, 에이전트에게 프로덕션 크래시를 그대로 재현하는 쪽으로 방향을 꺾으라고 했다.
프로덕션 크래시를 로컬에서 다시 만들다
결론부터 말하면, 프로덕션과 같은 경로의 크래시를 로컬에서 만들어 냈고 LICM 을 끄자 사라졌다. 크래시 지점까지 같았으니, 내가 막은 것이 프로덕션을 죽인 바로 그 경로라는 증거다.
| 프로덕션 | 로컬 재현 | |
|---|---|---|
| 프레임 | J 2698 c1 TokenQueue.matchesAny([C)Z |
J 105 c1 TokenQueue.matchesAny([C)Z |
| 크래시 지점 오프셋 | +0xbf |
+0xbf |
coder 레지스터 |
0 = LATIN1 | 0 = LATIN1 |
| LICM 을 끄면 | — | 생존 |
컴파일 번호는 실행마다 달라지지만, 같은 코드가 같은 방식으로 컴파일됐다면 크래시 지점 오프셋은 같아야 한다. 둘 다 +0xbf 였다.
재현 환경은 AWS 가 공개한 Lambda 베이스 이미지 public.ecr.aws/lambda/java:2112 이었다. 여기에 실제 jsoup 1.18.3 을 올리고, TokenQueue 의 queue 와 pos 를 리플렉션으로 채워 matchesAny 를 반복 호출했다. 처음에는 아무리 돌려도 죽지 않았다. C1 의 인라이닝 로그를 켜 보니 이런 줄이 있었다.
@ 21 java/lang/StringUTF16::charAt (not loaded) not inlineable
StringUTF16 클래스가 로딩되지 않아 UTF-16 경로가 아예 컴파일되지 않은 것이다. 하네스에 음표 기호(♫) 하나로 UTF-16 문자열을 만들어 두자, 비로소 끌어올린 로드가 생겼다.
돌아보면 얄궂은 대목이다. 헛걸음 실험은 "깨진 글자가 크래시의 방아쇠" 라는 가설을 쫓고 있었다. 깨진 글자는 범인이 아니었지만, 한글이 무관하지도 않았다. 멀쩡한 한글 문자열 하나가 StringUTF16 을 로딩시켜 둬야 결함이 생긴다.
이 발견은 반대 방향으로도 나를 물었다. UTF-16 문자열이 없어야 하는 대조군에서 크래시가 나서 확인해 보니, 내가 넣은 한글 로그 한 줄("StringUTF16 안 건드림")이 바로 그 클래스를 로딩시키고 있었다.
끌어올린 로드가 생긴 뒤에도 크래시는 드물었다. 죽으려면 GC 가 배열을 힙 경계에 딱 붙여 줘야 하기 때문이다. 나는 그 우연을 기다리는 대신 판을 키웠다. 문자열 길이를 60만으로 늘리고 pos 를 끝에 두자, 로드가 배열 끝을 600KB 가까이 넘어서 배열이 survivor 공간 어디에 놓이든 힙 경계 밖을 읽었다. 상류 테스트와 달리 Latin-1 문자열과 범위 안 인덱스라는 프로덕션의 경로는 그대로 두고, 넘어 읽는 거리만 늘린 것이다. 20초씩 네 번 돌려 네 번 모두 죽었다.
arm64 함수는 한 번도 죽지 않았지만, 실행 횟수가 적어 그것만으로는 안전하다고 볼 수 없었다. 같은 하네스를 ARM 머신에서 네이티브로 돌려 보니, arm64 도 똑같이 죽고 똑같이 막혔다.
관측만으로는 3주가 걸릴 판정을 실제 Lambda 의 A/B 와 로컬 재현으로 앞당겼다. 두 곳 모두 LICM 을 끄자 크래시가 사라졌고, arm64 도 같았다.
4부. 결론
원인은 Lambda 가 켜 둔 C1 전용 모드 안의 JDK 결함이었다. 내 코드도, 입력 데이터도, 메모리 부족도 아니었다. 그리고 나는 이 결함을 고친 것이 아니라 우회했다. 결함은 JDK 안에 있어서 내 코드로는 고칠 수 없다. 대신 결함이 발동하는 길인 C1 의 LICM 을 플래그 하나로 껐다.
조치는 3부의 A/B 와 재현으로 이미 확정했다. 남은 것은 이 함수를 Lambda 에 계속 둘 것인가였다. 우회는 다른 곳에 부작용을 남길 수 있어서, 조치 뒤에도 이 함수를 계속 지켜봤다. 플래그에 대한 기준은 단순했다. 크래시가 한 번이라도 재발하면 플래그가 듣지 않는 것이다. 성능과 수집 품질은 사건 전부터 있던 기준선을 그대로 썼다. 이 함수는 크롤러를 Lambda 로 옮겨도 되는지 가늠하는 시험대였고, 콜드 스타트의 초기화가 5초를 넘거나 매장별 크롤 실패율이 1% 를 넘으면 Lambda 로 옮길 이유가 없다고 정해 두었다.
되돌리는 길은 처음부터 있었다. Lambda 가 멈추면 유예 시간 뒤 인클러스터가 매장을 이어받는다. 이번 크래시의 30여 분 공백을 메운 것도 이 구조다. Lambda 가 다시 죽더라도 최악은 유예 시간만큼의 공백이지 수집 중단이 아니어서, 지켜보는 동안에도 부담이 적었다.
실제로는 세 선 모두 안쪽이었다. 조치 뒤 22일 동안 x86 과 arm64 두 함수가 677번 돌았고, 크래시는 한 번도 없었다. x86 만 보면 551번이고, 조치가 효과가 없었다면 이만큼 무사고일 확률은 4% 남짓이다. 기저율이 크래시 한 건에서 나온 추정이라 참고치일 뿐이지만, 3부의 A/B 와 재현이 가리킨 방향과 같았다. 3부에서 기다리지 않기로 했던 3주가 지나, 관측이 확인으로 돌아온 셈이다. 초기화 시간 중앙값은 x86 기준 2.8초로 조치 전과 같았고, 초기화를 포함한 과금 시간 중앙값도 6.7초에서 6.5초로 사실상 같았다. 최근 7일 동안 x86 의 매장 크롤 3,458번 가운데 실패는 1번, arm64 는 0번이었다.
기준선을 모두 확인한 뒤, 나는 이 함수를 Lambda 에 남기기로 했다. 원인을 밝혔고 플래그 하나로 막았으며 운영 지표도 기준 안이었으니, 여기서 마무리하지 않을 이유가 없었다. 크롤러 전환은 콜드 스타트가 더 빠른 arm64 로 가기로 했지만, 3부에서 봤듯 arm64 도 같은 결함에 걸리므로 플래그는 그대로 따라간다. 근본 수정은 JDK 28 에 들어갔고 JDK 21 계열에는 아직 백포트가 없다. 백포트가 Lambda 런타임에 들어오면, 로컬 재현 하네스가 그 JDK 에서 살아남는지 확인한 뒤 플래그를 뗀다.
5부. 회고
돌아보면 이 사건에서 가장 비싼 대목은 결함이 아니라 헛걸음이었다. 결함이 남긴 것은 30여 분의 수집 공백이었다. 헛걸음은 실험용 Lambda 를 세우고 허무는 데 MR 여러 건을 들였고, 6만 번의 크롤링은 아무것도 증명하지 못했다.
세션 단절은 계기였을 뿐, 변명이 되지는 않는다. 기록이 없어도 붙잡을 수 있는 단서가 있었다. 크래시가 셀렉터를 해석하다 났다는 것은 그때도 알고 있었고, 깨진 글자가 거기 닿지 않는다는 것도 보았다. 나는 그 단서를 가설을 버릴 이유가 아니라 나중에 풀 의문으로 미뤄 두었다. 그 의문을 먼저 끝까지 따라갔다면 6만 번의 본 실험은 필요 없었다.
그 헛걸음에서 세 가지가 남았다.
상관보다 메커니즘을 먼저 본다. 타이밍이 아무리 잘 맞아도, 원인 후보에서 크래시 지점까지 가는 경로가 코드에 없으면 가설이 아니다. 상관은 의심할 이유는 되지만 근거는 되지 못한다.
검출기가 무엇을 잡는지 먼저 확인한다. 희귀한 크래시는 기다려서 판정할 수 없으니 재현과 A/B 에 기대게 된다. 그런데 0건은 깨끗하다는 뜻일 수도 있고, 검출기가 엉뚱한 곳을 보고 있다는 뜻일 수도 있다. 게이트는 매번 죽는 크래시만 잡았고, 대조군은 내 로그 한 줄에 망가졌다. 검출기는 만든 사람 손에서도 조용히 죽는다.
결론은 근거와 함께 다시 읽는다. 헛걸음은 크래시 당일의 분석 대신, 상류 테스트에서 끌어낸 결론 한 줄을 들고 출발한 데서 시작됐다. 어떤 근거에서 나온 결론인지 묻지 않으면, 합성 테스트의 조건이 프로덕션의 사실처럼 행세한다. 판단 직전에는 내가 기대는 것이 원본 증거인지, 누군가 정리한 결론인지부터 확인한다.
그리고 런타임을 옮길 때는 JVM 도 함께 바뀐다고 전제하자. jar 와 JDK 버전이 같아도 JIT 설정은 런타임이 정한다. 옮기기 전에 -XX:+PrintFlagsFinal 을 양쪽에서 찍어 비교하면 이번 사건의 출발점이 바로 보인다.
같은 jar 는 같은 바이트코드를 보장한다. 같은 어셈블리까지 보장하지는 않는다.
참고
-
JDK-8386708: OpenJDK 결함 리포트와 공식 우회책 ↩
-
compilerDefinitions.inline.hpp#L69:emulated-client를 붙이는is_c1_simple_only()↩ -
c1_ValueMap.cpp#L509: 루프 불변 코드 이동은optimistic일 때만 실행된다 ↩ -
c1_Compilation.hpp#L259:is_optimistic()는 C1 단독이면서 프로파일을 모으지 않을 때 참이다 ↩ -
String.charAt: Latin-1 과 UTF-16 분기 ↩ -
c1_GraphBuilder.cpp#L4432:getChar인트린직의 범위 검사 플래그 ↩ -
커밋
9b357dac: JDK 28 수정과 회귀 테스트TestIntrinsicLoadSegfault↩